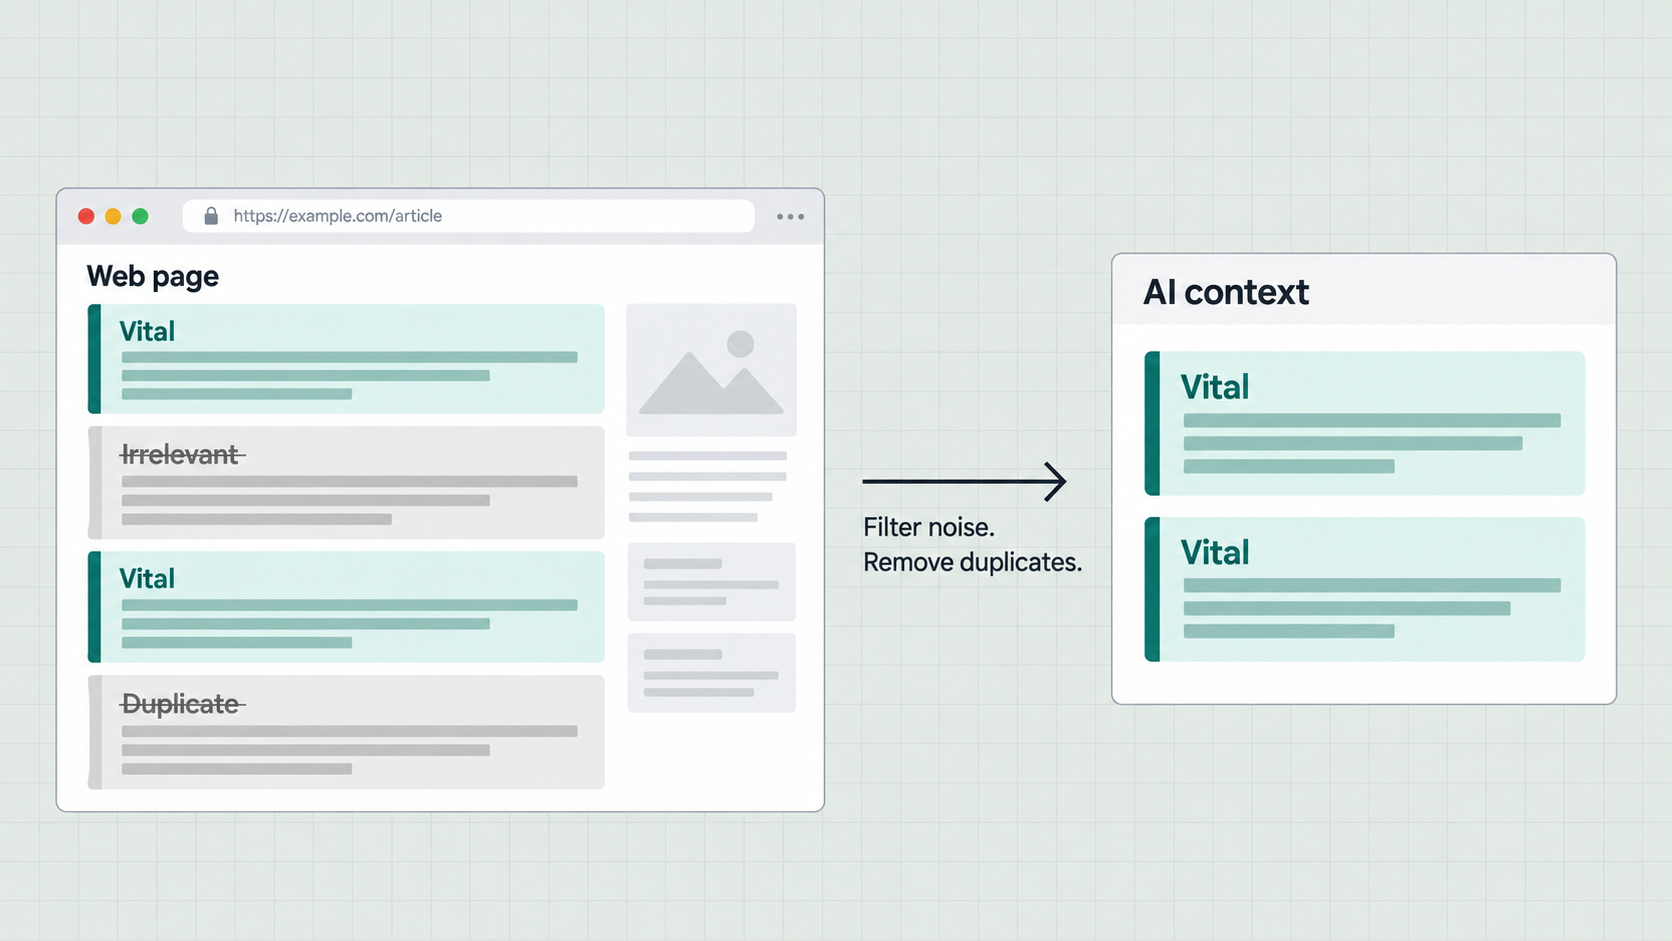
AI 提示词工程指南:针对 GEO 研究反向工程搜索行为

AI 提示词工程指南:逆向拆解 AI 搜索行为,做好 GEO 内容
引言
市面上的提示词教程,大多在教你"怎么向 AI 提问"。这篇指南反其道而行——我们要逆向拆解的是:AI 系统到底是怎么去搜索信息的。
搜索行为已经发生了底层变化。如今的提示词长度可能是传统搜索词的 20 倍 [27],谷歌的 AI Overviews 已经出现在 60% 以上的搜索结果里 [28]。一句话:AI 可见度,已经成了新的兵家必争之地。这篇文章会带你走进生成式引擎优化(GEO)的逆向提示词工程,跳出传统 SEO 的套路,手把手教你如何分析研究型提示、解码 AI 的搜索规律,并把内容结构调整成"AI 愿意引用、愿意推荐"的样子。
一、先搞懂 AI 搜索行为的底层逻辑
AI 搜索靠的是一套多层技术架构,和传统的"关键词匹配"完全是两回事。搞懂这套机制,你就会明白:为什么内容策略必须从"盯着单个关键词"转向"做透一个完整主题"。
AI 模型是怎么处理你的搜索的
你向一个 AI 搜索平台抛出一个问题。系统会在毫秒级完成查询分析,判断你的意图、问题复杂度,以及需要什么形式的回答 [15]。这次初判,决定了一次搜索够不够,还是要触发"扇出"(fan-out)机制。
所谓查询拆解,就是把你这一个提示词,拆成多个覆盖不同角度的子查询。比如"怎么创业"这一问,会被拆成关于商业计划、法律手续、融资、营销的多条搜索。接着系统并行检索,同时在 Google、Bing、Brave 等网页索引,外加知识图谱和专业数据库里,把这些扇出查询一次性跑完 [15]。
到了合成阶段,系统会用倒数排名融合(RRF)把多份搜索结果列表合并打分——核心逻辑是:奖励那些在多份列表里反复出现的文档。每个文档按它在各列表里的相关性和排名位置打分。比如一个页面在一份列表里排第 2、在另一份里排第 5,得分就是 1/2 + 1/5。出现在越多列表里的文档,累计分越高。这也正好解释了:为什么覆盖了多个扇出角度的深度长文,更容易被引用 [15]。
现代大模型里的"路由系统"
现代大模型系统会用语义路由器,把进来的请求分发给模型池里最合适的那个模型。路由器用 BERT 模型读懂请求的语义,把提示词转成向量嵌入,再和各任务的特征向量做比对,最后选出对应该任务的那个大模型 [29]。
这种路由带来两个好处。一是性能更好:数学题交给数学专长的模型,创意写作交给写作型模型。二是省成本:简单的查询被分流给更小、更便宜的模型 [29]。说白了,路由器要做的,就是在给定一组模型的前提下,在预算约束内把准确率拉到最高 [30]。
扇出查询的规律与七种模式
研究显示,平均每个提示词会触发 9–11 条扇出查询,其中 59% 会触发 5–11 条搜索。但也有 24% 会触发 12–19 条,最多甚至能达到 28 条。你的提示词越模糊、上下文越缺失,扇出的深度就越大 [15]。
扇出查询通常遵循七种典型模式:
| 扇出类型 | 说明 | 子查询示例 |
|---|---|---|
| 相关话题 | 提供背景的关联主题 | "备餐保鲜盒""简单备餐食谱""备餐收纳技巧" |
| 隐含问题 | AI 预判你"没说出口"的顾虑 | "太阳能板多少钱""太阳能板安装要多久""太阳能板回本计算器" |
| 对比类查询 | 并列对照评估 | "Asana vs Monday""适合小团队的项目管理工具""项目管理软件价格对比" |
| 时效类 | 优先抓取最新信息的时间敏感型搜索 | "2026 最佳智能手机""最新手机发布""2026 年 2 月口碑手机榜" |
| 同义改写 | 同一意图的不同说法 | "提升网站互动""让访客停留更久""降低网站跳出率" |
| 情境变体 | 基于用户历史或位置的定制角度 | "[用户所在城市]最佳餐厅""现在营业的好餐厅" |
| 下一步查询 | 用户在原始搜索之后会采取的动作 | "糖尿病怎么确诊""糖尿病治疗方案""糖尿病饮食计划" |
来源验证机制
AI 生成的文本天生带着验证难题——模型会"幻觉",凭空生成错误或没有依据的信息。文本生成工具可能编造内容、引用根本不存在的来源,或者用一本正经的权威口吻抛出假信息。所以在评估 AI 结果时,你评估的对象应该是"这个说法本身",而不是"这个来源"。验证方法很直接:去政府网站、权威新闻、研究数据库里,看看这个说法能不能在另一个可信来源里被印证。AI 有时会给出引用,那就用 Google 学术或图书馆检索工具去查这个来源——如果你压根找不到,那这条引用很可能就是它幻觉出来的 [3]。
二、什么是面向 GEO 的逆向提示词工程
AI 里的"逆向工程",本意是把模型拆开,分析它的结构和运行机制 [4]。把这个思路搬到搜索优化上,整个打法就反过来了:我们不再去猜用户"可能会搜什么",而是去分析他们"实际向 AI 输入了什么",再把这套语言逆向还原进我们的内容策略里。
给"AI 语境下的逆向工程"下个定义
逆向提示词工程(Reverse Prompt Engineering, RPE)指的是:仅凭大模型的文本输出,去反推它最初用的提示词。这套技术把模型当成黑盒,通过分析它生成的回答,用迭代优化不断逼近原始提示 [5]。而我们在 GEO 场景里用法略有不同:我们不去复原一模一样的提示词,而是把优质的 AI 输出摆出来,反问系统"什么样的查询能产出这样的结果" [6]。这能帮我们摸清:到底是什么样的提示模式,会带来详尽、且被充分引用的回答。
具体做法,是拿一条成功的 AI 答案,拆解它的结构要素,再倒推回去:是什么样的研究型提示,催生了这套特定的信息架构?换句话说,你要问的是——如果这就是 AI 给出的答案,那是什么样的问题框架产出了它?
传统 SEO vs 生成式引擎优化(GEO)
SEO 的地基是链接和网页权重 [7],而 GEO 靠的是语言和引用。这是可见度衡量逻辑的一次根本性转变。传统 SEO 盯的是"让页面在特定关键词下排名靠前""优化单个 URL",并用流量、用点击来衡量成败。GEO 追求的则是"被选为可信来源""建立品牌层面的认知",去影响 AI 最终生成的那段答案 [8]。
在这个新格局里,被引用率比点击率更重要 [7]。当 ChatGPT 整合多个来源给出答案时,你内容的价值,不在于作为一条"可点击的结果"出现,而在于"被写进答案本身"。搜索行为也变了:用户现在输入的提示词平均长达 23 个词,而传统搜索只有 4 个词,单次会话时长甚至拉长到约 6 分钟 [7]。
为什么必须分析搜索行为
消费者行为的变化是剧烈的。研究显示,80% 的消费者在至少 40% 的搜索中依赖 AI 摘要,传统网站点击量因此被砍掉了多达 25%。那些没有 AI 可见度策略的公司,正在经历两位数的流量下滑 [9]。在这样的变局下,搞懂用户如何构建研究型提示,已经成了维系数字存在感的关键。
AI 在回答问题时,并不会简单地把排名最高的页面拎出来。它会从那些它认为准确、权威、结构清晰的来源里整合信息 [8]。所以你的内容,必须和用户在向这些系统提问时所用的语言模式对齐。而逆向提示词工程,正是通过分析成功的 AI 交互,帮你识别出这些模式。
"深度研究活动"分析法
落到实操,核心是分析 AI 的研究会话,从中提取真实的查询模式。具体来说:跑一批深度研究(deep research)查询,再分析它的活动记录(activity transcript),你就能识别出 AI 在拆解复杂问题时,究竟生成了哪些具体的搜索串。这套方法能揭示扇出的主题分布和来源筛选标准,也能暴露出"决定哪些内容被引用"的推理路径。我们把这些模式记录下来,用来指导内容结构,确保我们的素材能匹配上 AI 替用户做调研时所用的查询语言。
三、分析 AI 搜索模式的分步框架
想分析 AI 的搜索模式,你需要系统化地观察研究会话。下面这套框架,会带你一步步从深度研究活动里提取可落地的洞察。
第 1 步:跑深度研究查询
在 ChatGPT 里直接输入 /deepresearch 即可启动,你也可以从工具菜单或侧边栏里选。开跑之前,先把问题描述清楚,写明你想要的结果和相关约束条件 [10]。Gemini、Perplexity 等平台也有类似的启动方式 [11]。系统会先抛给你一份研究计划,你可以在它正式执行前审阅、调整 [10]。研究时长视复杂度从 5 分钟到 30 分钟不等 [12]。
第 2 步:导出活动记录
研究完成后,会以全屏报告视图打开,带有导航元素。其中的"活动历史"区,会原原本本展示这次研究是怎么一步步推进的。ChatGPT 的 Conversation API 会把深度研究活动,详列在任务发起的那段对话里。这份记录,就是你做逆向工程的首要数据源。把完成的报告导出成 Markdown、Word 或 PDF 格式,就可以拿来分析了 [10]。
第 3 步:定位搜索查询日志
活动记录会暴露出 AI 在研究过程中生成的那些具体搜索串。系统会把复杂查询拆成一个个可管理的子任务,并决定哪些并行执行、哪些串行执行 [13]。搜索查询日志会展示模型如何把你的提示词,转化成精准的搜索语句——它会根据识别出的意图,自动追加"tutorial""guide"之类的词 [2]。这些日志,把 AI 检索信息时真实的语言模式,赤裸裸地摆在了你面前。
第 4 步:梳理研究阶段与主题
深度研究分为三个清晰的阶段:规划、搜索、报告 [13]。模型会在逻辑化地组织报告的同时,识别出关键主题和信息间的矛盾点 [13]。深入看看系统是如何给信息归类的:留意哪些主题被当成了主线、哪些是支线,以及子任务又是怎么挂接到更大的研究目标上的。这套梳理,能帮你看清那些值得做进内容里的主题集群。
第 5 步:分析来源筛选标准
AI 评估来源,看的是三件事:相关性、权威性、时效性。带有清晰 Schema 标记、结构良好的来源,会被优先对待;系统也偏爱覆盖全面的内容,胜过那种切口很窄的素材 [2]。回头看看哪些域名出现在了引用里,留意那些通过了"可信度门槛"的来源类型和内容结构有什么共性。
第 6 步:记录推理模式
思考面板会显示模型学到了什么、下一步打算怎么走 [13]。这些推理轨迹,展示了 AI 在做决策前是如何"思考"的 [14]。记录下系统是怎么评估信息质量、怎么处理互相打架的来源、又是怎么把零散发现合成为连贯叙述的。这些模式,会反过来指导你:该如何组织内容,才能和 AI 的推理过程对上拍。
四、把搜索洞察变成 GEO 优化内容
把搜索洞察用到内容创作上,需要你在结构上做些深思熟虑的取舍。核心原则是:围绕"观察到的 AI 检索模式"来优化,而不是围绕"想当然的用户行为"。
让内容结构对齐扇出主题
你的内容,应该映射到 AI 生成的扇出模式上。实体密集型查询,需要的是把属性讲清楚、配上结构化数据——产品类内容就该主打型号对比、参数规格、兼容性表格。重在"用户旅程"的主题,则需要覆盖认知、决策、落地各阶段的内容集群。信任密集型话题,要靠 E-E-A-T 信号和第三方背书。而对比类查询,最吃"并列对照"这一套——把决策标准做成表格,效果尤其好 [15]。
为"被 AI 引用"而设计的信息结构
每个段落,都应该在开头的 40–60 个词里给出直接答案 [16]。因为 AI 引擎用的是检索增强生成(RAG),它会挑那些"不依赖上下文也能独立回答问题"的段落。所以,把 60–180 词的内容单元做成可以独立成立的"金句段落"。研究显示,44.2% 的 AI 引用都来自页面前 30% 的正文 [17]。每个单元都应该有一个主题句,配上数据这类支撑证据,最后用一句可落地的结论收尾 [16]。
对比表格与数据格式
当 AI 系统在整合对比型答案时,表格能让它精准地抽取数据 [18]。表头要用"Mailchimp 定价"这种描述性标签,别用"选项 A"这种笼统的叫法;所有单元格的单位和术语要保持一致。带表格的内容被引用的概率,是纯文字内容的 2.5 倍 [19]。切记:永远不要把表格做成图片,因为 AI 读不了图片里的文字 [18]。
用例文档
FAQ 板块,是 AI 平台上被引用最多的内容格式之一 [17]。每一组问答,都应该被设计成一个完整的答案单元。实验表明,配上规范 Schema 的 FAQ 内容,能让 AI 引用量暴涨 350% [16]。
Schema 与结构化数据落地
优先级最高的 Schema 类型包括:FAQPage(引用率最高 [20])和 Article(用于内容署名归属 [1])。HowTo 适合流程类内容 [21],带 Offer 标记的 Product 适合商业页面 [22]。带规范 Schema 的页面,被 AI 答案引用的概率要高出 30–40% [17]。Schema 应采用 JSON-LD 格式,放在页面的 head 区 [23]。
五、逆向工程研究的工具与方法
逆向提示词工程的技术基建,由三部分组成:AI 研究平台、记录处理工具、自动化竞品分析系统。
大模型研究分析器的搭建
深度研究能连接到公网之外、需要授权的数据源。你可以把 Google Drive、SharePoint 这类文档库,以及 FactSet、PitchBook、Scholar Gateway 这类行业数据库整合进来。由于来源筛选看的是可信度和可追溯性,这些连接就显得格外关键 [10]。
ChatGPT 深度研究界面
截至 2026 年 2 月,该平台已运行在 GPT-5.2 上,并支持更精细的引导和站点级范围限定。ChatGPT Pro 订阅用户每月有 250 次查询额度,价格为 200 美元/月;Plus 用户每月 25 次;免费用户每月可用 5 次轻量查询 [24]。报告支持导出为 Markdown、Word、PDF,并自带目录和来源核验区 [10]。
活动记录分析工具
像 Looppanel 这类 AI 记录分析平台,转写准确率超过 90%,支持 17 种语言。系统会按问题自动生成归类笔记,把复盘时间压缩 80%,起价 30 美元/月。其他可选平台还有:做高级编码的 NVivo、做混合方法研究的 MAXQDA,两者都提供企业定制报价 [25]。
竞品内容分析方法
自动化工作流,解决的是竞品分析里的规模化难题。Searchapi.io 能抓取 SERP 数据,提供 100 次免费搜索用于验证;Firecrawl 能爬取整页内容,起价 16 美元/月。智能体会识别出竞品们的结构模式、内容深度、标题层级,再产出带优先级的优化建议 [26]。
结语
把这一切串起来看:我们已经走出了"传统关键词定位"的时代,进入了一个"AI 引用率决定可见度"的新阶段。这篇文章带你走了一遍如何逆向拆解 AI 搜索行为——你学会了分析深度研究记录、梳理扇出查询模式,也学会了把内容结构调整成"AI 愿意引用"的样子。
我们讲的这套框架,给了你一条系统化的 GEO 优化路径:从导出活动日志开始,一直走到落地 Schema 标记。动手跑跑你自己的深度研究查询,分析那些记录,你会从中挖出和你所在行业高度相关的具体语言模式。
AI 搜索行为,毫无疑问还会继续演进。但"做透深度内容""用好结构化数据"这两条原则,会一直是你的根基。把内容做成"值得被引用"的样子,你才能真正握住自己数字存在感的主动权。
参考文献
[1] - https://searchengineland.com/schema-markup-ai-search-no-hype-472339
[2] - https://skyscale.com.au/blogs/how-chatgpt-selects-sources
[3] - https://www.unr.edu/ai/students/ai-and-research/source-evaluation
[4] - https://blog.ai-laws.org/reverse-engineering-in-ai-balancing-innovation-and-ip-protection/
[5] - https://learnprompting.org/docs/language-model-inversion/reverse-prompt-engineering
[7] - https://a16z.com/geo-over-seo/
[8] - https://www.sharpinnovations.com/blog/2026/01/generative-engine-optimization-geo-and-why-it-matters/
[9] - https://www.forbes.com/sites/johnwerner/2025/05/04/as-ai-use-soars-companies-shift-from-seo-to-geo/
[10] - https://help.openai.com/en/articles/10500283-deep-research-in-chatgpt
[11] - https://wondertools.substack.com/p/deepresearch
[12] - https://openai.com/index/introducing-deep-research/
[13] - https://gemini.google/overview/deep-research/
[14] - https://machinelearning.apple.com/research/illusion-of-thinking
[15] - https://ahrefs.com/blog/query-fan-out/
[16] - https://otterly.ai/blog/how-to-optimize-content-for-ai-search/
[18] - https://www.amicited.com/faq/should-i-use-tables-content-ai-search/
[21] - https://rankharvest.com/structured-data-markup-for-geo/
[22] - https://www.useomnia.com/knowledge-base/structured-data-for-geo
[23] - https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data
[24] - https://en.wikipedia.org/wiki/ChatGPT_Deep_Research
[25] - https://www.looppanel.com/blog/transcript-analysis-tool
[26] - https://cxl.com/blog/automated-competitor-seo-analysis/
[27] - https://www.orbitmedia.com/blog/reverse-prompt-engineering/
[28] - https://www.linkedin.com/posts/majavoje_ahrefspartner-activity-7353755829365276672-Cjv9
[29] - https://developers.redhat.com/articles/2025/05/20/llm-semantic-router-intelligent-request-routing